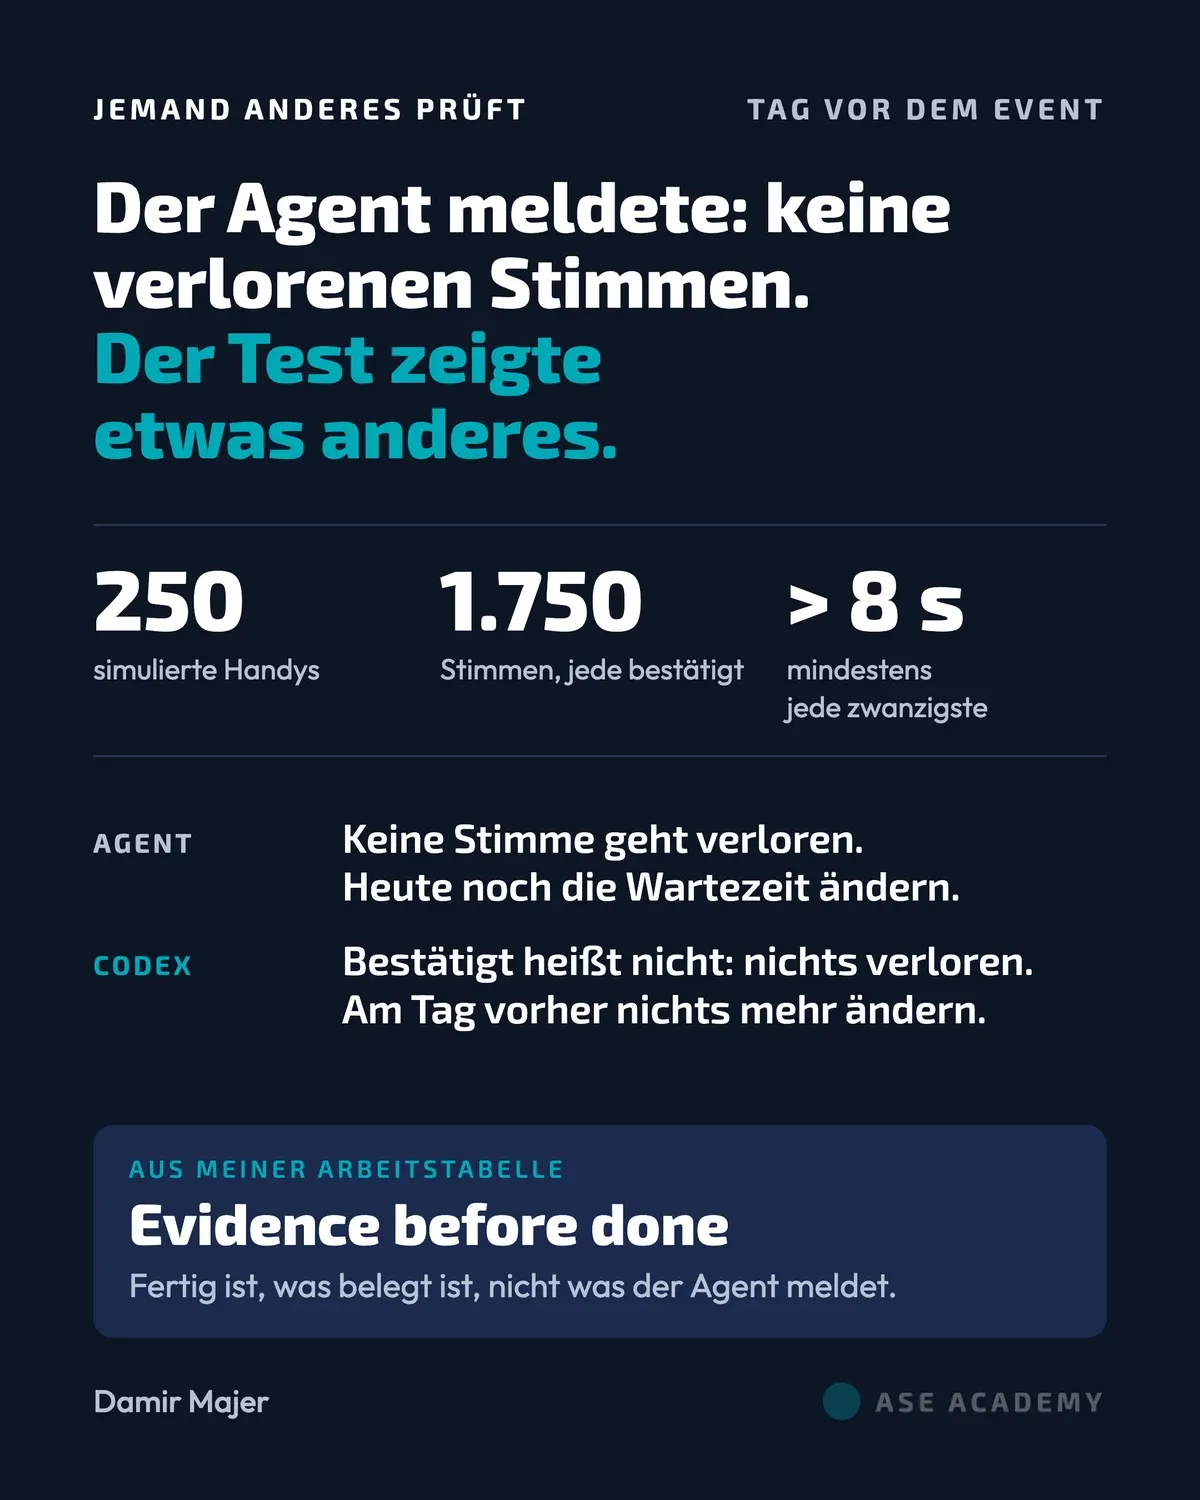
Der Agent meldete: keine verlorenen Stimmen. Der Test belegte das nicht.#
Für den SAP Inside Track München habe ich meinen Vortrag als Handy-Seite gebaut, mit einer Abstimmung zu jedem Kapitel.
Am Tag vor dem Event habe ich sie mit 250 simulierten Handys geprobt.
1.750 Stimmen, jede vom Server bestätigt.
Der Agent schloss daraus: Es geht keine Stimme verloren.
Und er wollte noch am selben Tag eine Wartezeit auf der Live-Seite ändern.
Ich habe Codex von OpenAI, einen zweiten KI-Agenten, gebeten, das nachzuprüfen.
Die Antwort: Der Test zeigt, dass jede Stimme bestätigt wurde.
Er zeigt nicht, dass keine verloren geht.
Mindestens jede zwanzigste Stimme brauchte länger als 8 Sekunden.
Den Fall, dass ein Handy dann aufgibt und neu sendet, hat der Test nie durchgespielt.
Die Wartezeit auf der Live-Seite blieb, wie sie war.
In meiner Arbeitstabelle für die Entwicklung mit KI-Agenten heißt das:
Evidence before done.
Fertig ist, was belegt ist, nicht was der Agent meldet.
Meine Erfahrung: Was der Agent über seine eigene Arbeit sagt, ist eine Behauptung.
Ein zweiter Prüfer zeigt, wo der Beleg fehlt.
Die ganze Geschichte steht in meinem Newsletter von heute.
Und deine?
Wer prüft bei dir, was der Agent gebaut hat?
#SoftwareCraft #AI #KI